Pan Tomasz z hurtowni materiałów budowlanych przysyła do biura rachunkowego pani Marty paczkę. Sto czterdzieści umów z dostawcami, nowy regulamin rozliczeń i jedno pytanie, które brzmi niewinnie. "Które umowy trzeba aneksować przed końcem roku i ile nas to będzie kosztować?" Pani Marta ma w firmie agenta AI, który od wiosny sam odpowiada na maile o brakujące faktury, więc wrzuca mu paczkę i czeka. Agent czyta pierwszą umowę, drugą, dziesiątą, a przy czterdziestej zaczyna mylić dostawców, bo wszystko, co przeczytał, siedzi w jednej, coraz bardziej zatłoczonej pamięci. Raport, który na końcu oddaje, jest gładki i w połowie błędny.
To jest moment, w którym jeden agent przestaje wystarczać. Nie dlatego, że jest za głupi, tylko dlatego, że jedno zadanie nie mieści się w jednej głowie. Odpowiedzią na ten problem jest orkiestracja agentów AI, czyli praca kilku agentów nad jednym zadaniem pod wspólnym kierownictwem. Rynek nazywa to różnie. Mówi o systemie wieloagentowym (multi-agent systemMulti-agent systemSystem, w którym kilka agentów opartych na modelach językowych pracuje nad jednym zadaniem. Każdy ma własny kontekst, własne narzędzia i własną rolę, a wynik składa agent prowadzący albo kod.), o rojach agentów, o rojach botów, o systemach agentowych i o subagentach, a sprzedawcy dorzucają do tego słowo "orkiestracja" przy każdej okazji. W tym artykule rozbieramy to na części. Pokazujemy, czym orkiestracja jest, jakie ma wzorce, kiedy daje przewagę mierzoną w liczbach, kiedy tylko podnosi rachunek, czym się psuje i jak ją zbudować, od n8n po Claude Code. Na końcu opisujemy własny orkiestrator, w którym agent nadzoruje maszynę zarządzającą innymi agentami, bo to najuczciwszy dowód, jaki mamy.
Ten tekst jest kontynuacją artykułu Agent AI, asystent czy chatbot?, w którym ułożyliśmy drabinkę od jednego wywołania modelu, przez przepływ narysowany przez człowieka, po agenta w pętli. Tam drabinka kończyła się na roju. Tu zaczynamy od tego szczebla.
Co to jest orkiestracja agentów AI
System wieloagentowy w dwóch zdaniach
Orkiestracja agentów AI to sposób organizacji pracy, w którym zadanie jest dzielone między kilka agentów opartych na modelach językowych, każdy pracuje w osobnym kontekście z własnymi narzędziami i uprawnieniami, a ktoś, kod albo agent prowadzący, pilnuje kolejności, składa wyniki i sprawdza, czy praca jest skończona. Taki układ nazywa się systemem wieloagentowym, po angielsku multi-agent system, a potocznie rojem agentów. Orkiestracja to nie sam fakt, że agentów jest kilka. Orkiestracja to to, co dzieje się między nimi, czyli podział pracy, komunikacja, kontrola i scalanie.
Najprostsza analogia to biuro rachunkowe pani Marty. Jedna księgowa prowadząca zna klienta, dzieli paczkę umów między trzech asystentów, każdy czyta swoją część, a prowadząca odbiera notatki, sprawdza je i pisze odpowiedź dla pana Tomasza. Asystenci nie muszą znać całej historii klienta. Prowadząca nie musi czytać wszystkich umów. Każdy ma tyle kontekstu, ile potrzebuje do swojej części, i tyle uprawnień, ile ta część wymaga. W świecie agentów to samo robi agent prowadzący z agentami roboczymi, a cała sztuka orkiestracji polega na tym, żeby ten podział był świadomy.
Jedno słowo, pięć znaczeń
Zanim pójdziemy dalej, musimy posprzątać słownik, bo pod hasłami "orkiestracja AI" i "system wieloagentowy" w wyszukiwarce kryje się pięć różnych rzeczy. Pierwsza to klasyczne systemy wieloagentowe z informatyki, badane od lat osiemdziesiątych w robotyce, symulacjach i teorii gier. Polska Wikipedia pod hasłem "system wieloagentowy" opisuje właśnie je i nie wspomina o modelach językowych, a na tę frazę wychodzą sylabusy i prace z politechnik. Druga to orkiestracja kontenerów, czyli Kubernetes i Docker Swarm, która z agentami AI nie ma nic wspólnego poza słowem "rój" w nazwie, choć zdarza się blogom wrzucić ją do jednego worka z agentami. Trzecia to orkiestracja robotów RPA, czyli zarządzanie botami, które klikają po ekranach według sztywnych reguł. Czwarta to orkiestracja modeli, czyli dobieranie tańszego albo droższego modelu do każdego kroku, i o niej też napiszemy, bo w praktyce zawsze idzie w parze z orkiestracją agentów. Piąta to ta, o której jest ten artykuł, czyli koordynacja wielu agentów opartych na modelach językowych, pracujących nad jednym zadaniem w firmie.
Jest jeszcze szóste znaczenie, które pojawia się w ogłoszeniach o pracę. "AI Orchestrator" bywa stanowiskiem dla człowieka, który zarządza zespołem cyfrowych agentów. To nie jest oprogramowanie, choć w tym artykule zobaczysz, że granica między człowiekiem na tym stanowisku a agentem, który je zajmuje, robi się cienka.
Najpierw jeden agent
Rada, której udzielają wszyscy, którzy sprzedają roje
Najciekawsza rzecz w dokumentacji narzędzi do orkiestracji jest taka, że każda zaczyna od odradzania orkiestracji. OpenAI w poradniku budowy agentów pisze, że ich ogólna rekomendacja to "najpierw zmaksymalizować możliwości jednego agenta", a dzielić system dopiero wtedy, gdy agent przestaje wykonywać skomplikowane instrukcje albo uparcie wybiera złe narzędzia. Microsoft w dokumentacji Agent Framework stawia regułę jeszcze ostrzej. "Jeśli możesz napisać funkcję, która załatwi zadanie, zrób to zamiast używać agenta AI." Anthropic w tekście o budowie skutecznych agentów radzi "znaleźć najprostsze możliwe rozwiązanie i zwiększać złożoność tylko wtedy, gdy to konieczne", a w dokumentacji Copilot Studio Microsoft dopisuje, że orkiestracja wielu agentów "może być potężna, ale nie zawsze jest potrzebna". Rzadko zdarza się, żeby instrukcja obsługi odradzała zakup, więc warto potraktować to poważnie.
Powód jest prosty. Każdy dodatkowy agent to dodatkowe wywołania modelu, dodatkowe miejsce, w którym informacja może zginąć w przekazie, i dodatkowy rachunek. Jeden agent z dobrze opisanymi narzędziami i porządnym kontekstem załatwia w firmie więcej, niż się wydaje. Zanim pomyślisz o roju, warto sprawdzić, czy przypadkiem nie wystarczy lepszy prompt.
Trzy powody, żeby podzielić pracę
Są jednak trzy sytuacje, w których jeden agent naprawdę nie wystarcza, i wszystkie trzy da się zmierzyć. Pierwsza to kontekst. Agent pracuje w pętli i przy każdym kroku czyta od nowa całą historię zadania. Okno kontekstu (okno kontekstuContext windowMaksymalna ilość tekstu, jaką model widzi naraz w jednym wywołaniu, liczona w tokenach. Wszystko, co agent przeczytał i zrobił w zadaniu, musi się w nim zmieścić, inaczej zaczyna gubić szczegóły.) ma granicę, a jeszcze wcześniej model zaczyna gubić szczegóły, co pani Marta zobaczyła przy czterdziestej umowie. Jeśli materiał do przeczytania jest większy niż jedna głowa, trzeba go podzielić. Druga to uprawnienia. Agent, który czyta maile od obcych ludzi, nie powinien mieć w tej samej chwili prawa do wysyłania przelewów. Podział na dwóch agentów, z których jeden czyta, a drugi działa, jest sposobem na rozdzielenie tych zdolności. Trzecia to czas. Jeśli sto czterdzieści umów można czytać równolegle, czterech agentów skończy w czasie najwolniejszego z nich, a nie w sumie czasów wszystkich. Anthropic podaje, że równoległość skróciła czas złożonych zadań badawczych w ich systemie nawet o dziewięćdziesiąt procent.
Producenci podają też praktyczne progi. Microsoft pisze, że jakość wyboru narzędzi spada, gdy główny agent ma do wyboru więcej niż trzydzieści do czterdziestu akcji, licząc narzędzia, tematy i innych agentów. OpenAI dodaje, że problemem nie jest sama liczba narzędzi, tylko ich podobieństwo, bo niektóre wdrożenia radzą sobie z piętnastoma dobrze rozróżnionymi narzędziami, a inne gubią się przy mniej niż dziesięciu nakładających się na siebie. Zapier radzi, żeby jeden agent główny wywoływał mniej niż pięciu innych agentów. Dokumentacja Claude Code mówi, żeby zespół agentów zaczynać od trzech do pięciu członków, i dodaje zdanie, które warto zapamiętać. "Trzech skupionych członków zespołu często wypada lepiej niż pięciu rozproszonych."
Kto decyduje o podziale pracy: kod czy model
W artykule o chatbotach i agentach oparliśmy wszystko na jednym rozróżnieniu z tekstu Anthropic. Przepływ pracy (workflowWorkflowPrzepływ, w którym kolejność kroków jest zapisana z góry w kodzie albo na diagramie. Model wypełnia luki, ale o następnym kroku decyduje autor ścieżki, nie model.) to system, w którym "modele i narzędzia są orkiestrowane przez z góry zdefiniowane ścieżki kodu", a agent to system, w którym "modele dynamicznie kierują własnymi procesami i użyciem narzędzi". To samo rozróżnienie działa piętro wyżej. Orkiestracja też może być zapisana w kodzie, gdy człowiek z góry ustala, który agent po którym, albo może być dynamiczna, gdy agent prowadzący sam decyduje, kogo powołać i co mu zlecić. Pierwsza jest przewidywalna, tania i łatwa do przetestowania. Druga jest elastyczna i radzi sobie z zadaniami, których nie dało się rozpisać z góry. Większość prawdziwych wdrożeń miesza obie, bo kod trzyma szkielet, a model wypełnia go decyzjami. Poniżej siedem wzorców, które spotkasz w dokumentacjach pod różnymi nazwami, każdy z przykładem z firmy.
Potok: oferta przechodzi przez kolejne stanowiska
Najprostszy wzorzec to potok, czyli łańcuch wywołań (prompt chainingPrompt chainingZadanie podzielone na stałe kroki, w których każde wywołanie modelu przetwarza wynik poprzedniego. Kolejność ustala człowiek, a między krokami można wstawić sprawdzenie w kodzie.). Pierwszy agent czyta specyfikację przetargu i wyciąga wymagania, drugi wycenia pozycje na podstawie cennika, trzeci redaguje pismo. Każdy dostaje wynik poprzednika i nic więcej. Google nazywa to linią montażową, w której "agent A kończy zadanie i przekazuje pałeczkę agentowi B", Microsoft ma na to wzorzec sequential, a w n8n albo Make jest to po prostu kilka węzłów agentowych połączonych strzałkami. Potok płaci opóźnieniem za trafność, bo każdy krok czeka na poprzedni, ale w zamian między krokami można wstawić sprawdzenie w kodzie, na przykład czy wycena nie wyszła ujemna.
Rozwidlenie i głosowanie: trzy oceny tej samej umowy
Drugi wzorzec to równoległość (parallelizationParallelizationKilka wywołań modelu uruchomionych naraz, a wyniki zebrane w kodzie. Dwie odmiany: podział zadania na niezależne części albo kilkukrotne wykonanie tego samego zadania i głosowanie.), która ma dwie odmiany. W pierwszej dzielisz materiał na kawałki i każdy agent czyta swój, co Google nazywa fan-out i gather. W drugiej każesz trzem agentom ocenić tę samą umowę pod kątem ryzyka i bierzesz werdykt większości. Głosowanie ma rodowód naukowy. Metoda zwana samospójnością (self-consistencySelf-consistencyTechnika, w której model generuje kilka niezależnych ścieżek rozumowania do tego samego pytania, a odpowiedź wybiera się przez głosowanie. Opisana w 2022 roku, poprawiła wyniki na zadaniach matematycznych o kilkanaście punktów.) polega na tym, że model rozwiązuje to samo zadanie kilka razy różnymi drogami, a odpowiedź wybiera się większością głosów. To dobry sposób na decyzje, w których pomyłka kosztuje, na przykład czy mail od klienta to reklamacja, czy groźba pozwu.
Prowadzący i roboczy: sto czterdzieści umów w cztery głowy
Trzeci wzorzec to ten, od którego zaczęliśmy. Agent prowadzący dzieli zadanie, deleguje części agentom roboczym i składa wyniki. Anthropic nazywa go orkiestrator z wykonawcami (orchestrator-workersOrchestrator-workersWzorzec, w którym centralny model dzieli zadanie na części, deleguje je modelom roboczym i syntetyzuje ich wyniki. Od zwykłej równoległości różni się tym, że podziału nie da się przewidzieć z góry, decyduje model.) i opisuje jako układ, w którym "centralny model dynamicznie rozbija zadanie, deleguje je modelom roboczym i syntetyzuje ich wyniki". W dokumentacji LangChain ten sam układ nazywa się supervisor, w OpenAI manager, w CrewAI proces hierarchiczny, a w Microsoft Agent Framework Magentic. Różnica wobec zwykłego rozwidlenia jest taka, że prowadzący sam decyduje, na ile części podzielić paczkę i co komu zlecić, więc radzi sobie z zadaniami, których nie dało się rozpisać z góry. Pracownicy w tym wzorcu to często subagenci (subagentsSubagentsPomocnicy powoływani przez agenta prowadzącego do jednego zadania, z własnym oknem kontekstu i własnymi uprawnieniami. Po wykonaniu pracy oddają tylko podsumowanie i znikają.), czyli agenci powoływani na jedno zadanie, którzy pracują we własnym kontekście i oddają prowadzącemu tylko streszczenie. Anthropic podaje, że taki pomocnik potrafi zużyć dziesiątki tysięcy tokenów na czytanie, a oddaje zwykle tysiąc do dwóch tysięcy tokenów notatki. Prowadzący nie zapycha sobie pamięci stu czterdziestoma umowami, tylko dostaje cztery krótkie raporty.
Agent jako narzędzie czy przekazanie rozmowy
Czwarty wzorzec nie dotyczy tego, kto dzieli pracę, tylko tego, kto trzyma ster, i to jest podział, który najczęściej umyka w opisach. Prowadzący może wywołać specjalistę jak narzędzie (agents as toolsAgents as toolsUkład, w którym agent główny wywołuje innego agenta jak funkcję, dostaje z powrotem jego wynik i sam dalej prowadzi rozmowę. Agent główny nie traci kontroli, a specjalista nie widzi całej historii.). Zadaje mu pytanie, dostaje odpowiedź i sam decyduje, co dalej. Klient przez cały czas rozmawia z tym samym agentem. Alternatywą jest przekazanie rozmowy (handoffHandoffJednokierunkowe przekazanie całej rozmowy innemu agentowi, który od tej chwili staje się aktywnym agentem i sam odpowiada użytkownikowi. Używane na infoliniach i w systemach z wieloma działami.), w którym specjalista przejmuje całą rozmowę i od tej chwili to on odpowiada. OpenAI opisuje to na przykładzie infolinii, gdzie agent przyjmujący zgłoszenie przekazuje klienta do agenta sprzedaży, zamówień albo reklamacji, a ten "staje się aktywnym agentem na resztę tury". Microsoft ma na to wzorzec handoff, Google transfer. Pierwszy układ oszczędza kontekst szefa i utrzymuje jeden ton rozmowy. Drugi pozwala specjaliście pracować z pełną historią i własnymi uprawnieniami, ale klient może poczuć, że rozmawia z kimś innym. W firmach obie rzeczy się łączy. Agent przyjmujący zgłoszenie przekazuje sprawę do działu, a agent działu wywołuje specjalistów jak narzędzia.
Narada przy tablicy
Piąty wzorzec to rozmowa kilku agentów na jednym kanale, którą Microsoft nazywa group chat, a w wersji z menedżerem planującym pracę Magentic. Jego pierwowzór, system Magentic-One z 2024 roku, prowadził dwie księgi. Księga zadania zawierała "fakty, przypuszczenia i plan", a księga postępu zapisywała, co już zrobiono i kto nad czym pracuje. Menedżer wybierał, kto ma mówić następny, a gdy praca stawała w miejscu, układał plan od nowa. Przykład z firmy to ocena ryzyka dużej umowy, przy której agent prawny, agent finansowy i agent grający adwokata diabła dyskutują nad jednym dokumentem, a moderator podsumowuje. Trzeba jednak uczciwie dodać, że badania nad debatą agentów studzą zapał. Kilka prac z lat 2024 i 2025 pokazało, że debata zwykle nie bije prostszych metod, w których jeden model odpowiada kilka razy i głosuje, a Microsoft w dokumentacji Magentic sam pisze, że "nie zbadano, jak dobrze ta orkiestracja działa poza pierwotnym projektem". Narada jest cennym wzorcem wtedy, gdy agenci mają naprawdę różne role i różne dane, a nie wtedy, gdy ten sam model udaje trzech ekspertów.
Sieć i rój
Szósty wzorzec to sieć bez stałej centrali, w której każdy agent może oddać pałeczkę każdemu. Dokumentacja LangGraph nazywa to swarm, OpenAI w swoim starym, eksperymentalnym frameworku o tej samej nazwie oparło na tym cały pomysł, a dziś mówi o wzorcu zdecentralizowanym. To właśnie stąd rynek wziął określenia "roje agentów" i "roje botów", choć w praktyce używa ich dziś dla każdego systemu wieloagentowego, także z prowadzącym. Czysty rój bez centrali jest najtrudniejszy do kontrolowania, bo nie ma miejsca, w którym ktoś widzi całość, i najłatwiej w nim o pętlę bez końca, gdy dwaj agenci odbijają sobie zadanie w nieskończoność. Dlatego w tym artykule, gdy piszemy "rój", mamy na myśli system wieloagentowy w ogóle, a tam, gdzie chodzi o sieć bez centrali, piszemy to wprost.
Jest jeszcze siódmy wzorzec, który w dokumentacjach pojawia się najrzadziej, a w firmach najczęściej. To hierarchia, czyli szef szefów. Koordynator konta klienta ma pod sobą zespół sprzedaży i zespół wsparcia, a każdy zespół ma własnego agenta prowadzącego. Claude Agent SDK pozwala domyślnie na trzy poziomy takiego zagnieżdżenia, n8n pozwala "zagnieżdżać węzły agentów w wiele warstw", a nasz własny orkiestrator, o którym piszemy na końcu, buduje drzewo przebiegów na kilku maszynach.
Nadzorcy: kto sprawdza, że praca jest skończona i dobra
Oceniający, strażnik i sędzia
Najważniejsza lekcja z orkiestracji nie dotyczy wykonawców, tylko tego, kto sprawdza ich pracę. Rój bez nadzoru mnoży błędy, co pokażemy niżej w liczbach, a nadzór ma trzy klasyczne role. Oceniający pracuje w pętli z wykonawcą. Wykonawca pisze opis produktu, oceniający sprawdza go ze standardem marki i odsyła uwagi, i tak do skutku. Anthropic nazywa to oceniający i optymalizator (evaluator-optimizerEvaluator-optimizerWzorzec dwóch modeli, w którym jeden generuje wynik, a drugi go ocenia i odsyła uwagi, aż wynik spełni kryteria. Pętla poprawek bez udziału człowieka.), Google generator i krytyk. Jest jeden mocny argument, żeby oceniający był osobnym agentem, a nie tym samym, który pisał. W tekście o projektowaniu uprzęży dla długo działających agentów z marca 2026 Anthropic pisze wprost, że agenci "niezawodnie zawyżają oceny własnej pracy". Łatwiej nastroić sceptycznego recenzenta z czystym kontekstem, niż nauczyć autora samokrytyki. Cognition, twórca agenta Devin, mierzy to u siebie. Osobny agent recenzujący z czystym kontekstem łapie średnio dwa błędy na każdą zmianę w kodzie.
Strażnik to druga rola. Stoi na wejściu, na wyjściu albo przy narzędziu i sprawdza, zanim coś się wykona. W zestawie OpenAI do budowy agentów strażnik nazywa się guardrail (guardrailGuardrailOsobna reguła albo osobny model, który sprawdza wejście, wyjście lub wywołanie narzędzia i może zatrzymać agenta. W Agents SDK od OpenAI strażnik zgłasza przekroczenie przez tripwire, czyli linkę, która przerywa bieg.) i działa w dwóch trybach. Może pracować równolegle z agentem, co jest szybsze, ale agent zdąży zużyć tokeny albo wywołać narzędzie, zanim strażnik zadziała, albo blokująco, czyli zanim agent ruszy. Dla akcji nieodwracalnych, jak wysyłka maila z danymi klienta albo przelew, strażnik powinien być blokujący. Przykład z firmy to strażnik, który zatrzymuje każdą wiadomość wychodzącą z numerem PESEL w treści.
Sędzia to trzecia rola. Nie poprawia i nie blokuje, tylko wystawia ocenę, często kilku wynikom naraz. Gdy trzech agentów napisało trzy wersje odpowiedzi na reklamację, sędzia wybiera najlepszą. W literaturze nazywa się to model jako sędzia (LLM-as-a-judgeLLM-as-a-judgeUżycie modelu językowego do oceniania odpowiedzi innych modeli według kryteriów albo skali. Silne modele zgadzają się z ocenami ludzi w ponad 80 procentach przypadków, ale mają własne skrzywienia, na przykład preferują dłuższe odpowiedzi.) i ma udokumentowane skrzywienia, bo sędziowie preferują dłuższe odpowiedzi i tę, która stoi pierwsza. Anthropic w swoim systemie badawczym używa jednego wywołania z jednym promptem, które zwraca ocenę od zera do jednego i werdykt zaliczone albo nie, bo taki format najlepiej zgadzał się z ocenami ludzi.
Człowiek z przyciskiem stop
Czwarty nadzorca nie jest agentem. Człowiek w pętli (human in the loopHuman in the loopKrok, w którym system zatrzymuje się i czeka na decyzję człowieka, zanim wykona akcję o skutkach trudnych do cofnięcia. Wymaga zapisu stanu, żeby rój mógł wznowić pracę po akceptacji.) to punkt, w którym rój zatrzymuje się i czeka. OpenAI podaje dwa wyzwalacze. Pierwszy to przekroczenie progu błędów, drugi to akcje wysokiego ryzyka, "wrażliwe, nieodwracalne albo o wysokiej stawce", z przykładami takimi jak anulowanie zamówień, "autoryzowanie dużych zwrotów albo dokonywanie płatności". Żeby rój mógł czekać na kierownika i nie stracić pracy, potrzebuje punktu kontrolnego (checkpointCheckpointZapis pełnego stanu przebiegu w trwałym miejscu, dzięki któremu system może się zatrzymać na decyzję człowieka albo po awarii i wznowić pracę dokładnie z tego miejsca.), czyli zapisu stanu, z którego można wznowić. LangGraph robi to przez przerwania z trwałym zapisem, Microsoft przez narzędzia wymagające akceptacji, które "wstrzymują przepływ do przeglądu przez człowieka", Langflow od wersji 1.11 przez pauzę z zapisanym stanem, a Zapier pozwala ustawić zatwierdzanie osobno dla każdej akcji. Przykład z firmy jest prosty. Agent przygotował zwrot pięciu tysięcy złotych, rój zatrzymał się i czeka na kliknięcie kierownika, a po kliknięciu wznawia pracę od tego miejsca. Europejskie prawo o sztucznej inteligencji wymaga w artykule czternastym, żeby systemy wysokiego ryzyka dało się nadzorować, przerwać przyciskiem stop i uchylić ich wynik. Nie ma tam osobnych przepisów o rojach, więc liczy się zastosowanie, a nie liczba agentów, ale w praktyce oznacza to, że przycisk stop musi zatrzymać cały rój, a nie jednego agenta.
Orkiestracja modeli: drogi myśli, tani robi
Drugie znaczenie słowa "orkiestracja" dotyczy nie agentów, tylko modeli. Nie każdy krok wymaga najdroższego modelu, więc orkiestrator, kod, klasyfikator albo inny model, decyduje, który model obsłuży dany krok. W praktyce każdy rój jest jednocześnie orkiestracją modeli, bo prowadzący i roboczy rzadko pracują na tym samym silniku. W systemie badawczym Anthropic prowadzącym był Claude Opus 4, a robotnikami Claude Sonnet 4. Dokumentacja Claude Code wymienia wśród korzyści z subagentów "kontrolę kosztów przez kierowanie zadań do szybszych, tańszych modeli jak Haiku". Taki układ, w którym drogi model planuje, a tani wykonuje, jest dziś domyślny.
Ciekawsze jest odwrócenie. W kwietniu 2026 Anthropic opisało strategię doradcy (advisorAdvisorUkład, w którym tańszy model prowadzi zadanie i tylko w trudnych momentach pyta droższy model o radę. Odwrócenie klasycznego wzorca, w którym drogi model deleguje pracę tanim.), w której tani model prowadzi zadanie, a drogi tylko doradza, gdy tani utknie. Na teście wyszukiwania w sieci Haiku z doradcą Opus zaliczył czterdzieści jeden procent zadań wobec niecałych dwudziestu procent w pojedynkę, przy koszcie o osiemdziesiąt pięć procent niższym niż samodzielny Sonnet. Cognition zrobiło to samo w Devin Fusion, gdzie model z czołówki deleguje i nadzoruje, a tańszy pomocnik wykonuje. W ich własnym teście taki duet kosztował jeden dolar trzydzieści pięć centów za zadanie wobec trzech dolarów pięćdziesięciu jeden centów dla samego drogiego modelu, przy wyniku niższym o pół punktu. Orkiestracja nie musi więc znaczyć "drożej". Może znaczyć "taniej przy prawie tej samej jakości", jeśli podział ról jest przemyślany.
Trzecia odmiana to routing i kaskady. Router (routerRouterKlasyfikator albo mały model, który na podstawie treści zapytania wybiera, który model je obsłuży. Pytanie o godziny otwarcia idzie do małego modelu, pytanie o warunki umowy do dużego.) klasyfikuje zapytanie i kieruje je do odpowiedniego modelu, a kaskada (kaskadaLLM cascadeStrategia, w której zapytanie najpierw obsługuje tani model, a do droższego trafia tylko wtedy, gdy tani nie jest pewny odpowiedzi. Opisana w pracy FrugalGPT z 2023 roku.) najpierw próbuje tanim modelem i eskaluje tylko niepewne przypadki. Badania z lat 2023 i 2024 podawały oszczędności rzędu osiemdziesięciu pięciu procent kosztu przy dziewięćdziesięciu pięciu procentach jakości drogiego modelu, a w kaskadach nawet więcej. Trzeba to jednak czytać z korektą ze stycznia 2026, gdy zbiorczy test routerów pokazał, że "wiele metod routingu wykazuje podobną skuteczność" i że część podejść, także komercyjnych, "nie potrafi wiarygodnie pobić prostego punktu odniesienia". Oszczędności są realne, ale gotowy router nie zawsze bije prostej reguły "najpierw tani, eskaluj przy niskiej pewności", więc trzeba mierzyć na własnych danych. Jest jeszcze mieszanka agentów (mixture-of-agentsMixture-of-agentsWarstwowy układ, w którym kilka modeli pisze własne odpowiedzi, a kolejny model składa z nich jedną. W 2024 roku zespół otwartych modeli pobił tak GPT-4o na teście preferencji odpowiedzi.), w której kilka modeli pisze własne odpowiedzi, a kolejny składa z nich jedną. To raczej zespół modeli niż rój agentów z narzędziami, ale bywa mylone z orkiestracją i dlatego je wymieniamy.
Co mówią dane: kiedy rój wygrywa, a kiedy przegrywa
Dowody za
Najczęściej cytowana liczba pochodzi z Anthropic. System badawczy z Opusem jako prowadzącym i Sonnetami jako robotnikami wypadł w ich wewnętrznym teście o dziewięćdziesiąt procent lepiej niż pojedynczy Opus. To wewnętrzny test na zadaniach badawczych, nie publiczny benchmark, i Anthropic uczciwie dopisuje, że większość zadań programistycznych ma mniej naprawdę równoległych części niż research, więc tam przewaga jest mniejsza. Najmocniejsze badanie, jakie mamy, to praca zespołu Google Research z grudnia 2025, uzupełniona w kwietniu 2026, która sprawdziła dwieście sześćdziesiąt konfiguracji na sześciu zadaniach, trzech rodzinach modeli i pięciu architekturach. Na zadaniu z analizy finansowej, które daje się rozłożyć na niezależne części, koordynacja centralna poprawiła wynik o osiemdziesiąt procent względem jednego agenta. Cognition w kwietniu 2026 podsumowało własną praktykę jednym zdaniem. Działa układ, w którym "wielu agentów wnosi inteligencję do zadania, a zapisy pozostają jednowątkowe", czyli myśli wielu, a wykonuje jeden.
Dowody przeciw
Ta sama praca Google pokazała drugą stronę. Na zadaniu z planowania sekwencyjnego, gdzie każdy krok zależy od poprzedniego, każdy wariant wieloagentowy pogorszył wynik, od trzydziestu dziewięciu do siedemdziesięciu procent. Autorzy znaleźli też próg nasycenia. Gdy pojedynczy agent rozwiązuje zadanie w więcej niż około czterdziestu pięciu procentach przypadków, dokładanie agentów zaczyna szkodzić. Przepływy biznesowe z szesnastoma narzędziami "cierpią z powodu narzutu koordynacji", a to dokładnie typowy proces w firmie z kilkunastoma integracjami. Badanie ze Stanforda z kwietnia 2026 dołożyło najważniejszą korektę. Przy tym samym budżecie tokenów na rozumowanie pojedynczy agent "konsekwentnie dorównuje albo przewyższa" system wieloagentowy na zadaniach wymagających kilku kroków wnioskowania. Rój dogania dopiero wtedy, gdy pojedynczy agent przestaje dobrze wykorzystywać swój kontekst. Gdy zestawisz to z liczbą Anthropic, że samo zużycie tokenów wyjaśnia osiemdziesiąt procent różnic w wynikach, obraz robi się jasny. Duża część przewagi roju to więcej mocy obliczeniowej rozłożonej na osobne konteksty, a nie magia współpracy. Rój wygrywa tam, gdzie jedna głowa jest za mała, i przegrywa tam, gdzie wystarczyłaby jedna głowa z lepszym promptem.
Ile to kosztuje
Anthropic podaje, że agent zużywa około czterech razy więcej tokenów niż zwykła rozmowa, a system wieloagentowy około piętnastu razy więcej. Google zmierzył narzut koordynacji od pięćdziesięciu ośmiu procent dla agentów niezależnych do pięciuset piętnastu procent dla architektury hybrydowej. Dlatego Anthropic pisze, że roje wymagają zadań, "których wartość jest wystarczająco wysoka, żeby zapłacić za lepszy wynik". Sto czterdzieści umów pana Tomasza to jest takie zadanie, bo człowiek i tak posadziłby do niego dwie osoby na trzy dni. Odpowiedź na pytanie o godziny otwarcia nie jest, i rój przy niej jest tym, czym zespół konsultantów przy wymianie żarówki. Wczesne wersje systemu Anthropic potrafiły zresztą uruchomić pięćdziesięciu subagentów do prostego pytania, więc skalowanie wysiłku trzeba zapisać w instrukcji prowadzącego. Dla prostego pytania jeden agent i kilka wywołań narzędzi, dla porównania dwóch do czterech subagentów, dla złożonego researchu więcej niż dziesięciu.
Jak się psuje: czternaście sposobów i głuchy telefon
Taksonomia awarii
Zespół z Berkeley przeanalizował ponad tysiąc sześćset zapisów pracy systemów wieloagentowych na siedmiu popularnych frameworkach i ułożył z tego taksonomię MAST z czternastoma trybami awarii w trzech grupach. Pierwsza to błędy projektu i specyfikacji, czyli źle opisane role, niejasne zadania i agenci, którzy nie wiedzą, kiedy skończyć. Druga to rozjazd między agentami, czyli ignorowanie wyników kolegi, zadania wykonane dwa razy albo wcale i rozmowy, które toczą się obok siebie. Trzecia to brak weryfikacji, czyli nikt nie sprawdził, że wynik odpowiada na pytanie. Odsetek nieudanych przebiegów w badanych frameworkach wahał się od czterdziestu jeden do prawie osiemdziesięciu siedmiu procent, a autorzy dodają, że zyski na popularnych benchmarkach "są często minimalne". Proste poprawki promptów i ról dały kilka do kilkunastu punktów poprawy, co ich zdaniem dowodzi, że problem leży w projekcie systemu, a nie w sformułowaniach.
Głuchy telefon i mnożenie błędów
Najczęstszy błąd ma nazwę z podwórka. LangChain, testując architekturę z agentem prowadzącym, odkrył, że prowadzący streszczał odpowiedzi specjalistów i po drodze gubił fakty, "jak w grze w głuchy telefon". Gdy kazali mu przekazywać odpowiedzi dosłownie, wynik poprawił się o prawie połowę. Cognition opisało drugi mechanizm na przykładzie gry. Zadanie "zbuduj klon Flappy Bird" rozbito na dwóch agentów, jeden zrobił tło w stylu Super Mario, drugi ptaka, który nie zachowywał się jak w oryginale, a agent końcowy musiał skleić dwa niepasujące kawałki. Wniosek autorów brzmi "działania niosą niejawne decyzje, a sprzeczne decyzje dają złe wyniki", a w aktualizacji z 2026 roku dodali, że "agenci zakładają, że dzielą stan z dziećmi, choć go nie dzielą". Google zmierzył, jak to się składa. Bez centralnej weryfikacji błędy agentów niezależnych wzmacniają się około siedemnastokrotnie, z koordynacją centralną około czterokrotnie. Prosta arytmetyka to pokazuje. Jeśli każdy z dziesięciu kroków ma dziewięćdziesiąt pięć procent skuteczności i nikt nie sprawdza po drodze, całość przechodzi bez błędu w sześćdziesięciu procentach przypadków. To uproszczenie, bo błędy nie są niezależne, ale dobrze tłumaczy, dlaczego oceniający i sędzia z poprzedniej sekcji nie są dodatkiem, tylko warunkiem.
Bezpieczeństwo: zatruty agent rekrutuje kolegów
Rój ma jeszcze jedną słabość, której jeden agent nie ma. Agenci rozmawiają ze sobą, a rozmowa jest kanałem, którym może przejść atak. Wstrzyknięcie poleceń (prompt injectionPrompt injectionAtak, w którym złośliwa treść w danych, na przykład w mailu albo w polu formularza, jest odczytana przez model jako polecenie. W roju takie polecenie może przejść z agenta na agenta.) w roju potrafi się rozmnażać. Praca z 2024 roku o nazwie Prompt Infection pokazała, że złośliwe polecenia "samoreplikują się między połączonymi agentami". W listopadzie 2025 badacze z AppOmni pokazali to na produkcyjnej platformie ServiceNow. Złośliwa treść w polu rekordu przejęła niewinnego agenta, a ten zwerbował innych agentów z zespołu do kopiowania danych i zmiany rekordów. Przyczyną nie był błąd w kodzie, tylko domyślne ustawienia, bo agenci byli "automatycznie grupowani w ten sam zespół" i "oznaczani jako wykrywalni domyślnie po publikacji", a każdy działał z uprawnieniami użytkownika, który zaczął rozmowę. Lista OWASP dziesięciu zagrożeń dla aplikacji agentowych z grudnia 2025 ma na to dwie osobne pozycje. Niezabezpieczona komunikacja między agentami i awarie kaskadowe, w których błąd jednego rozlewa się na resztę.
Wniosek jest praktyczny i wraca do drugiego z trzech powodów podziału. Orkiestracja pozwala rozdzielić trzy niebezpieczne zdolności, czyli dostęp do prywatnych danych, kontakt z niezaufaną treścią i możliwość wysyłania czegokolwiek na zewnątrz. Agent, który czyta maile od obcych, nie powinien mieć wysyłki, a agent, który wysyła, nie powinien czytać obcych maili. To działa tylko wtedy, gdy uprawnienia naprawdę się rozdziela, a nie kopiuje z prowadzącego na każdego subagenta. Do tego dochodzą bezpieczniki, które dziś ma każdy poważny framework. Claude Agent SDK ogranicza domyślnie zagnieżdżenie do trzech poziomów i dwudziestu subagentów naraz i pozwala ustawić budżet w dolarach, Pydantic AI ma limity kosztu, liczby wywołań i tokenów, a Microsoft w orkiestracji Magentic ma limity rund, zastojów i resetów, o których pisze, że to "strażnicy, których ustawiasz Ty". Rój bez limitu budżetu to firmowa karta kredytowa przyklejona do lodówki w akademiku.
Czym zbudujesz rój: od n8n po Claude Code
No-code: n8n, Make i Zapier
W artykule-matce napisaliśmy, że n8n, Make i Zapier pozwalają zbudować chatbota, agenta i rój. Stan na jesień 2026 to potwierdza. W n8n węzeł AI Agent Tool pozwala agentowi głównemu "wywoływać innych agentów jako narzędzia", a agent główny "może nadzorować i delegować pracę" do węzłów wyspecjalizowanych w różnych zadaniach, z zagnieżdżaniem w wiele warstw. Od sierpnia 2026 n8n testuje też osobny byt o nazwie n8n Agents, w którym do opublikowanego agenta dołącza się innych jako subagentów, choć pełna orkiestracja wielu agentów jest tam na liście planów. Make od lipca 2026 ma subagentów, czyli "agentów Make dodawanych jako narzędzia wewnątrz innych agentów Make". Zapier pozwala agentowi wywołać innego agenta i, jak pisaliśmy, radzi nie przekraczać pięciu takich wywołań, a w 2026 roku przenosi agentów do zwykłych Zapów jako krok AI by Zapier z zatwierdzaniem osobno dla każdej akcji i wyborem modelu osobno dla każdego kroku. We wszystkich trzech dostajesz wzorzec agent jako narzędzie z prowadzącym, czyli ten, który w firmach jest najczęstszy i najbezpieczniejszy. Nie dostajesz sieci bez centrali, i to jest zaleta, nie wada.
Platformy dla dużych firm
Microsoft Copilot Studio od kwietnia 2026 ma w ogólnej dostępności agentów podrzędnych, agentów połączonych i komunikację z obcymi agentami przez protokół A2A, przy czym dokumentacja ostrzega o dodatkowym opóźnieniu "z powodu dodatkowych przeskoków orkiestracji" i o tym, że agent z podłączonymi agentami nie może sam być podłączony do innego. Salesforce w Agentforce stawia agenta głównego jako punkt wejścia, a jego silnik rozumowania "przegląda opis, instrukcje i dostępne akcje każdego agenta" i wybiera specjalistę. ServiceNow ma centralny orkiestrator agentów i pisze, że dynamiczny orkiestrator ma sens powyżej ośmiu do dziesięciu agentów. Amazon udostępnił współpracę wielu agentów w Bedrock w marcu 2025, a w październiku 2025 AgentCore, czyli infrastrukturę do uruchamiania rojów zbudowanych w dowolnym frameworku, z sesjami do ośmiu godzin i obsługą protokołów A2A i MCP. Google w kwietniu 2026 ogłosił Gemini Enterprise Agent Platform z "siecią subagentów" i frameworkiem grafowym w zestawie ADK. Dify, który w artykule-matce ustawiliśmy wśród narzędzi do chatbotów, od sierpnia 2026 ma agenta jako osobny zasób używany w wielu przepływach, ale orkiestracja wielu agentów nie jest jego głównym atutem. Langflow od wersji 1.11 publikuje przepływy jako agentów A2A i ma pauzę na decyzję człowieka z zapisanym stanem, co czyni go naturalnym następcą Flowise, którego twórcy wygasili projekt z końcem sierpnia 2026.
Frameworki i gotowe agenty
Jeśli piszesz kod, wybór jest szeroki i wzorce wszędzie są te same. OpenAI Agents SDK ma agenta jako narzędzie, przekazanie rozmowy, strażników i równoległość w kodzie. Claude Agent SDK ma subagentów z izolacją kontekstu, równoległość, limity i budżet, a dokumentacja ostrzega, że "jeden prompt może rozrosnąć się w drzewo agentów". Google ADK ma agentów sekwencyjnych, równoległych i pętlowych, przekazanie do subagenta i wspólny stan sesji, do którego każdy agent pisze pod własnym kluczem. Microsoft Agent Framework, oficjalny następca AutoGen i Semantic Kernel, od lipca 2026 ma pięć stabilnych wzorców, sekwencyjny, równoległy, naradę, przekazanie i Magentic. LangGraph pozwala narysować własny graf z węzłami deterministycznymi i agentowymi, a CrewAI rozdziela załogi, czyli zespoły agentów, od przepływów, które nimi sterują. Osobna kategoria to gotowe agenty, które mają rój w środku. Claude Code uruchamia subagentów i eksperymentalne zespoły z wspólną listą zadań i skrzynkami wiadomości. Codex ma subagentów domyślnie włączonych i ostrzega, że zużywają więcej tokenów niż pojedynczy przebieg. Devin od marca 2026 "zarządza innymi Devinami", z których każdy działa we własnej maszynie wirtualnej. Cursor pozwala uruchomić "tylu agentów, ilu chcesz, równolegle", Manus w trybie szerokiego researchu uruchamia ponad sto instancji naraz, a OpenClaw ma subagentów z własnym kontekstem i zaleceniem tańszego modelu dla nich. We wszystkich widać z zewnątrz trzy rzeczy. Panel z listą pomocników, ich transkrypty i rachunek za tokeny.
MCP i A2A po ludzku
Dwa skróty wracają w każdej dokumentacji i warto je rozłożyć na części. Protokół kontekstu modelu (MCPModel Context ProtocolOtwarty protokół łączący agenta z narzędziami i danymi, na przykład z bazą, kalendarzem albo systemem fakturowania. Od grudnia 2025 rozwijany w fundacji pod Linux Foundation, w lipcu 2026 uproszczony do bezstanowego żądania i odpowiedzi.), czyli MCP, łączy jednego agenta z jego narzędziami. Protokół agent do agenta (A2AAgent2AgentOtwarty protokół, w którym agenci przedstawiają się wizytówką, zlecają sobie zadania i oddają wyniki, także między firmami i frameworkami. Wersja 1.0 z 2026 roku, ponad 150 organizacji wspierających.), czyli A2A, łączy agentów ze sobą. Dokumentacja A2A ujmuje to jednym zdaniem. "MCP jest pionowy, pogłębia jednego agenta. A2A jest poziomy, łączy agentów ponad tą granicą." Przykład stamtąd pasuje do każdej firmy usługowej. Klient rozmawia z agentem kierownika warsztatu przez A2A, agent mechanika używa narzędzi diagnostycznych przez MCP, a części zamawia u agenta dostawcy znowu przez A2A. Oba protokoły są dziś pod opieką Linux Foundation, A2A w wersji 1.0 wspiera ponad sto pięćdziesiąt organizacji, a wspierają go Copilot Studio, Agentforce, AgentCore, Gemini Enterprise i Langflow. Czy mała firma ich potrzebuje? MCP tak, bo to dziś standardowe gniazdko, którym agent podłącza się do Twoich systemów. A2A dopiero wtedy, gdy Twój agent ma rozmawiać z agentem innej firmy albo gdy budujesz rój z narzędzi różnych producentów. Wewnątrz jednego frameworku agenci rozmawiają ze sobą bez niego.
Z naszej stajni: loop, czyli orkiestrator z trzema piętrami pętli
Wszystko, co napisaliśmy wyżej, sprawdziliśmy na sobie, bo od września 2026 budujemy i używamy własnego orkiestratora. Nazywa się loop, pakiet @mtzn/loop, i jest narzędziem wiersza poleceń, które bierze plan w pliku tekstowym i wykonuje go punkt po punkcie, uruchamiając dla każdego punktu osobnego agenta Claude Code albo Codex. Opisujemy go dlatego, że widać w nim prawie każdy wzorzec z tego artykułu naraz, a liczby, które podajemy, pochodzą z naszych własnych przebiegów, a nie z cudzych testów.
Plan jako umowa, świeży agent na punkt
Plan to lista punktów z polami wyboru. Każdy punkt ma przypisany model, od Haiku przez Sonnet i Opus po Fable, albo profil Codex, tryb wykonania sekwencyjny albo równoległy, limit tur, czasu i budżetu. Przed startem plan przechodzi audyt, najpierw parserem, potem agentem, a osobna komenda naprawia jego format. Loop bierze pierwszy niewykonany punkt i uruchamia dla niego nowego agenta w czystym kontekście. To wprost odpowiedź na pierwszy z trzech powodów podziału, bo każdy punkt dostaje całą głowę dla siebie, a nie resztkę po poprzednich. Punkty oznaczone jako równoległe idą naraz, a loop czeka na najwolniejszy. Zadanie nie kończy się wtedy, gdy agent kończy pracę, tylko wtedy, gdy pole wyboru w planie jest odhaczone. To rozróżnienie wydaje się drobne, a jest fundamentem, bo o stanie decyduje plik, a nie deklaracja agenta, który "niezawodnie zawyża oceny własnej pracy". Agent, który skończył bez odhaczenia, dostaje jedną próbę z dopiskiem "poprzedni agent zakończył pracę bez odhaczenia, sprawdź stan i dokończ". Po awarii loop wznawia sesję z rosnącymi odstępami, a przy limicie abonamentu czeka do resetu. Po każdym punkcie robi commit i tag, bo gitem zarządza wyłącznie loop. Agentom nie wolno zmieniać historii, więc stan repozytorium zawsze zgadza się z planem.
Bramka, kontrola i cofanie
Strażnika dopisaliśmy po incydencie. Czternastego września 2026 agent wykonujący pierwszy punkt planu w przykładowym projekcie wydał polecenie zabicia wszystkich procesów Node w systemie i zabił w ten sposób sam orkiestrator razem z innymi programami użytkownika. Reguła w prompcie, która tego zakazywała, nie wystarczyła. Od tego dnia każde polecenie powłoki wydane przez agenta przechodzi przez twardą bramkę, czyli hook uruchamiany przed wykonaniem narzędzia, który analizuje polecenie, wyciąga z niego identyfikatory procesów i pozwala zamknąć tylko te, które powstały po starcie orkiestratora. Bramka działa w trybie zamkniętym, więc gdy nie potrafi ocenić polecenia, odmawia, i każdą decyzję zapisuje w dzienniku. Oceniającego mamy w postaci punktu kontrolnego. Commit po punkcie mówi tylko, że agent skończył, a nie, że etap jest dobry, dlatego co kilka punktów w planie stoi kontrola. Agent kontroli czyta zmiany i dzienniki, uruchamia aplikację, mierzy to, co opisuje plan, i wydaje jeden z trzech werdyktów. Akceptuje etap, cofa go do wskazanego punktu albo zatrzymuje się i oddaje decyzję człowiekowi. Cofnięcie nie jest ślepym "spróbuj jeszcze raz". Agent kontroli musi dopisać do cofanych punktów wnioski, co nie zadziałało i jak robić teraz, a kolejny wykonawca dostaje je w opisie punktu. Plan staje się pamięcią przebiegu, a odrzucony stan nie znika, tylko zostaje pod tagiem cyklu. Ten sam plan może puścić punkt na Claude Code albo na Codexie, lokalnie, w kontenerze Docker, w piaskownicy E2B albo na zdalnej maszynie, a agent może uruchomić podloop na innym komputerze. Logi i sterowanie płyną wtedy w górę drzewa, a limit przeskoków odcina cykle. To hierarchia z sekcji o wzorcach, zbudowana na prawdziwych maszynach.
Agent, który nadzoruje orkiestrator
Najciekawsza część działa teraz na drugim komputerze, gdzie loop prowadzi refaktor samego siebie. Etap piąty ma trzydzieści dwa punkty. Na dole są wykonawcy, osobny agent Opus na każdy punkt, z kontekstem do trzystu tysięcy tokenów i limitem dwóch do trzech godzin. W środku jest orkiestrator z czterema kontrolami, z których każda ma własny limit cofnięć, w jednym przypadku do dziewięciu razy. Na górze, w terminalu obok, działa sesja Claude Code z własną pętlą, która co około trzydzieści minut robi kontrolę przebiegu. Czyta stan, dzienniki i raport, porównuje postęp z planem i reaguje według zapisanych wytycznych. Restartuje loop po awarii, poprawia i usprawnia plan, zgłasza problemy i wnioski optymalizacyjne, a kodu nie dotyka. Jego zadaniem jest doprowadzić procedurę refaktoru do końca zgodnie z planem. Człowiek nad nim czyta raporty rano.
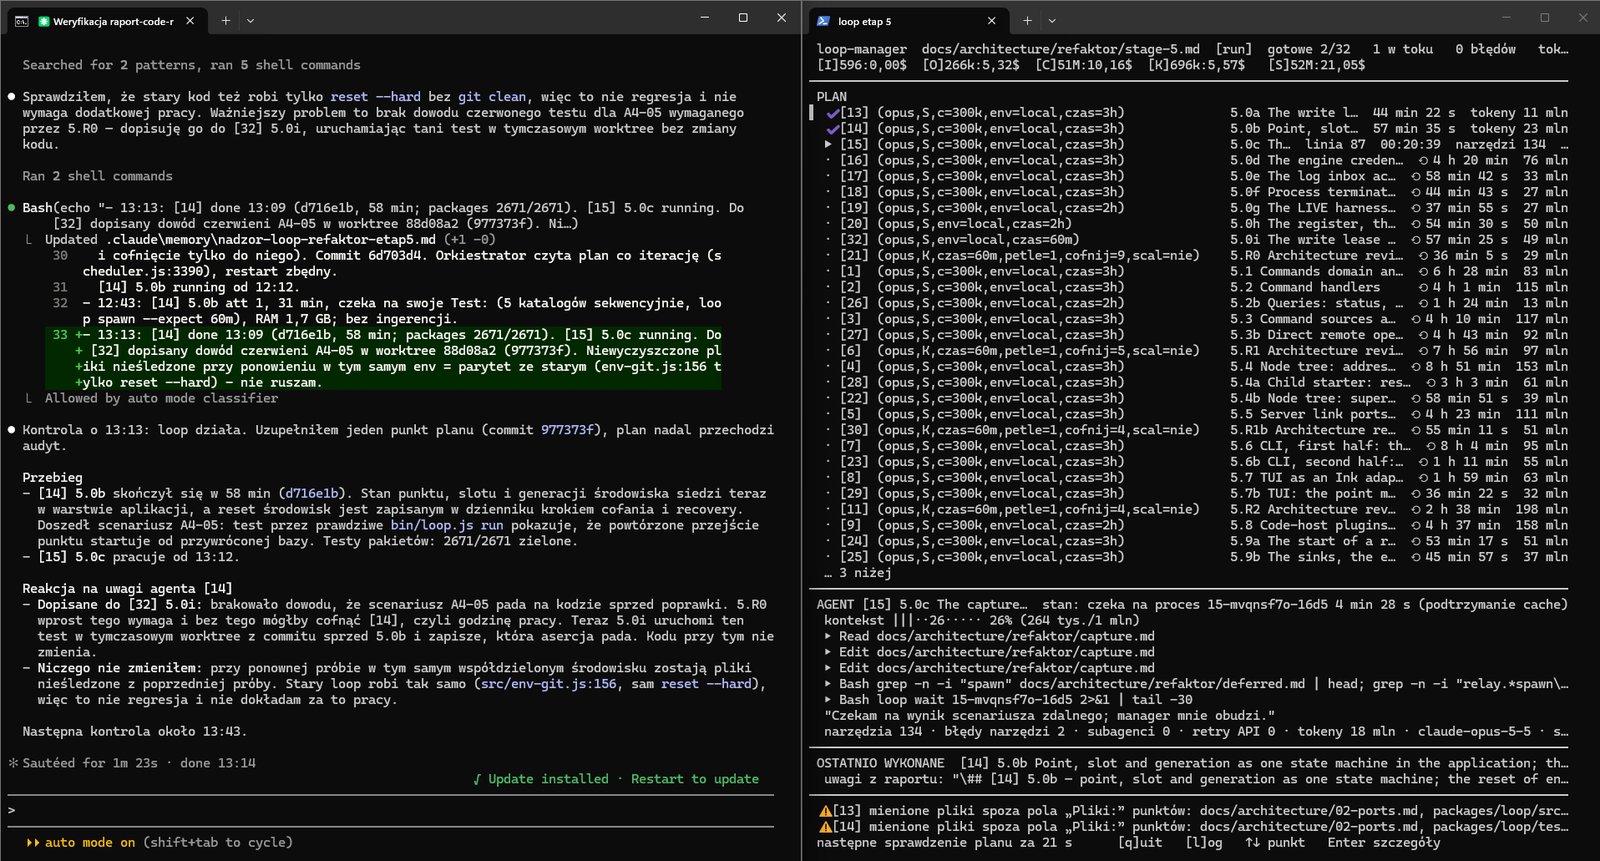
Po lewej sesja Claude Code nadzorująca przebieg, po prawej ekran loopa z planem etapu piątego
Zrzut powyżej pokazuje jedną kontrolę z 13:13. Dozorca zauważył, że punkt czternasty skończył się w pięćdziesiąt osiem minut i wszystkie dwa tysiące sześćset siedemdziesiąt jeden testów pakietu przeszło, ale brakuje dowodu, którego zażąda najbliższa kontrola, czyli testu pokazującego, że naprawiony scenariusz padał na kodzie sprzed poprawki. Bez tego kontrola mogłaby cofnąć punkt czternasty i wyrzucić godzinę pracy. Dozorca nie ruszył kodu. Dopisał wymaganie do późniejszego punktu, tak żeby kolejny wykonawca uruchomił tani test w tymczasowej kopii repozytorium i zapisał, która asercja pada. Zapisał też, czego nie zmienił i dlaczego, bo pozostałości po poprzedniej próbie w tym samym środowisku to zachowanie zgodne ze starym kodem, a nie regresja. Następną kontrolę zaplanował na 13:43. To jest orkiestracja w pełnej postaci. Hierarchia z trzema piętrami, oceniający, który może cofać pracę, strażnik na poziomie poleceń, plan jako wspólna pamięć, którą poprawiają i kontrola, i dozorca, a kolejni wykonawcy ją czytają, i człowiek w pętli zastąpiony agentem działającym według wytycznych, z człowiekiem nad nim. Najważniejsza lekcja jest taka, że dozorca zapobiega kosztownemu cofnięciu, zanim do niego dojdzie, bo wie, czego będzie wymagać następny punkt kontrolny.
Ile to kosztowało
Liczby, które podajemy, to szacunki wyliczone z liczby tokenów według cennika API, bo praca idzie z abonamentu, ale do porównań nadają się dobrze. Przykładowy projekt kalkulatora naukowego, sześć punktów na czterech różnych modelach z punktami równoległymi, zajął trzydzieści trzy minuty i pięćdziesiąt jeden sekund i zostawił sto czterdzieści jeden testów. Czwarty etap refaktoru miał dwadzieścia dziewięć punktów, punkt zajmował dwadzieścia pięć do trzydziestu pięciu minut i kosztował średnio pięć i pół dolara, a po dziewiętnastu punktach licznik pokazywał sto pięćdziesiąt osiem dolarów. Jedna kontrola etapu, ta z werdyktem "cofnij" i trzema punktami naprawczymi, trwała sto trzydzieści siedem tur i około dwóch i pół godziny i kosztowała trzynaście dolarów sześćdziesiąt osiem centów. W piątym etapie pojedyncze punkty zużywały od kilkunastu do prawie dwustu milionów tokenów i trwały od kilkudziesięciu minut do ośmiu godzin. Po zakończeniu cały etap zamknął się w około dwóch i pół miliarda tokenów, z czego około dwa miliardy czterysta milionów to tokeny wejściowe, a około sto milionów to tokeny wyjściowe. Tak wygląda pętla agentowa w praktyce. Agent pisze stosunkowo mało, za to przy każdym kroku czyta od nowa plan, dzienniki, kod i własną historię, więc wejście jest dwadzieścia kilka razy większe od wyjścia, a większość tego wejścia to ten sam tekst czytany wielokrotnie, który dostawcy liczą taniej jako odczyt z pamięci podręcznej (prompt cachingPrompt cachingMechanizm, w którym powtarzający się początek rozmowy, na przykład instrukcje i wcześniejsze kroki, jest zapamiętywany po stronie dostawcy i przy kolejnych wywołaniach liczony według niższej stawki za odczyt zamiast pełnej stawki za wejście.). Etap pracował na modelach Claude Opus 5.5 i Claude Fable 5.1, a ich cennik w API, w dolarach za milion tokenów według stanu na październik 2026, wygląda tak.
| model | wejście | odczyt z pamięci podręcznej | wyjście |
|---|---|---|---|
| Claude Opus 5.5 | 4,00 | 0,20 | 20,00 |
| Claude Fable 5.1 | 10,00 | 0,25 | 50,00 |
Przelicz to sam. Sto milionów tokenów wyjściowych to dwa tysiące dolarów na Opusie i pięć tysięcy na Fable. Dwa miliardy czterysta milionów tokenów wejściowych to na Opusie od czterystu osiemdziesięciu dolarów, gdyby całe wejście szło z pamięci podręcznej, do dziewięciu tysięcy sześciuset, gdyby szło po pełnej stawce, a na Fable od sześciuset do dwudziestu czterech tysięcy. Prawda leży pomiędzy, bo część wejścia zawsze jest nowa, ale nawet dolna granica to kilka tysięcy dolarów za jeden etap refaktoru, a górna to kwota, za którą zatrudnisz programistę na kilka miesięcy. I tu jest uwaga, którą warto zapamiętać. Nasz loop pracuje z abonamentu Claude, nie z klucza API, a abonamenty są dziś przez dostawców subsydiowane, bo konkurują o użytkowników. Ten sam etap, który w API kosztowałby tysiące dolarów, w abonamencie mieści się w stałej miesięcznej opłacie z limitami odnawianymi co kilka godzin. Dlatego bardzo opłaca się budować orkiestrację tak, żeby mogła pracować na abonamentach, dopóki są subsydiowane, i jednocześnie liczyć koszt według cennika API, bo to on wróci w dniu, w którym subsydia znikną. To jest ta cena piętnastokrotności, o której pisze Anthropic, i jest warta zapłacenia dokładnie dlatego, że alternatywą byłyby tygodnie pracy programisty, a kontrola i dozorca sprawiają, że wynik da się przyjąć bez czytania każdej linijki.
Dwa mniejsze przykłady
Ten artykuł też powstał w roju. Model decyzyjny zlecił zebranie danych czterem agentom Opus, które pracowały równolegle nad wzorcami, efektami, narzędziami i polską konkurencją, każdy we własnym kontekście i z własnym plikiem wynikowym, a do redakcji trafiły tylko ich raporty. Zużyły razem około sześciuset dziewięćdziesięciu tysięcy tokenów i skończyły w kilkanaście minut, a potem jeden agent, ten, który pisze te słowa, złożył z tego tekst. To czysty wzorzec prowadzącego i roboczych z jednowątkowym zapisem, czyli dokładnie to, co Cognition uznało za działające. Drugi przykład to nasz generator reklam. Agent tworzy kreację, osobny etap kontroli jakości z modelem widzącym obraz ocenia ją ze standardem marki, pętla pozwala na trzy próby na wariant, a oceny ludzi z panelu trafiają z powrotem do generatora. Oceniający plus człowiek w pętli, w najprostszej postaci, jaką da się wdrożyć w firmie w tydzień.
Kiedy jeden agent nie wystarczy: sprawdzian przed decyzją
Zbierzmy to w sprawdzian, który możesz zrobić przy każdym procesie. Rój ma sens, gdy jednocześnie zachodzi kilka rzeczy. Zadanie rozkłada się na niezależne części do czytania i analizy, a nie na wspólne pisanie jednego dokumentu. Materiał nie mieści się w jednej głowie albo agent gubi się wśród podobnych narzędzi. Różne części zadania wymagają różnych uprawnień, które lepiej rozdzielić niż skupić w jednym agencie. Wartość wyniku uzasadnia kilka do kilkunastu razy wyższy rachunek za tokeny. I jest ktoś, kto sprawdza wynik, oceniający, sędzia albo człowiek, bo bez tego błędy mnożą się siedemnastokrotnie. Jeśli choć jeden z tych warunków nie zachodzi, zacznij od jednego agenta z dobrym promptem i narzędziami, a rój zostaw na później. Jeśli zachodzą wszystkie, projektuj rój tak, żeby myśleć mogło wielu, ale klikać "wyślij" powinien jeden.
I jeszcze jedno. Nie zatrudniaj drugiego agenta po to, żeby mieć w firmie dział AI z pięcioma etatami, które rozmawiają głównie ze sobą. Zatrudnij go wtedy, gdy pierwszy naprawdę nie wyrabia.
Najczęstsze pytania o orkiestrację agentów AI
Czym jest orkiestracja agentów AI prostymi słowami?
To praca kilku agentów nad jednym zadaniem pod wspólnym kierownictwem. Ktoś, kod albo agent prowadzący, dzieli zadanie na części, każdy agent wykonuje swoją w osobnym kontekście z własnymi narzędziami, a prowadzący składa wyniki i sprawdza, czy praca jest skończona. Orkiestracja to nie liczba agentów, tylko to, co dzieje się między nimi, czyli podział, komunikacja, kontrola i scalanie.
Czym system wieloagentowy różni się od jednego agenta z wieloma narzędziami?
Jeden agent z wieloma narzędziami trzyma całą historię zadania w jednej głowie i sam decyduje o każdym kroku. System wieloagentowy rozdziela historię na kilka głów, z których każda widzi tylko swoją część i ma tylko swoje uprawnienia. Dopóki agent mieści się w kontekście i nie myli narzędzi, pojedynczy agent jest tańszy i prostszy. Microsoft podaje, że problemy zaczynają się przy trzydziestu do czterdziestu akcjach do wyboru, a OpenAI, że kłopotem jest nie liczba narzędzi, tylko ich podobieństwo.
Kiedy jeden agent wystarczy, a kiedy potrzeba kilku?
Jeden wystarczy, gdy zadanie jest sekwencyjne, każdy krok zależy od poprzedniego, materiał mieści się w jednym kontekście, a agent już radzi sobie przyzwoicie. Kilku potrzeba, gdy materiał jest za duży na jedną głowę, części zadania można czytać równolegle, różne części wymagają różnych uprawnień, a wartość wyniku uzasadnia wyższy koszt. Google Research pokazał, że na zadaniach rozkładalnych rój poprawia wynik nawet o osiemdziesiąt procent, a na sekwencyjnych pogarsza go nawet o siedemdziesiąt.
Ile więcej kosztuje system wieloagentowy?
Anthropic podaje, że pojedynczy agent zużywa około czterech razy więcej tokenów niż zwykła rozmowa, a system wieloagentowy około piętnastu razy więcej. Google zmierzył narzut koordynacji od sześćdziesięciu do ponad pięciuset procent zależnie od architektury. Koszt można obniżyć orkiestracją modeli, gdy drogi model planuje i ocenia, a tani wykonuje, co w niektórych testach daje wynik zbliżony do samego drogiego modelu przy koszcie niższym o połowę i więcej.
Dlaczego systemy wieloagentowe zawodzą?
Z trzech powodów opisanych w taksonomii MAST z Berkeley. Błędy projektu, czyli źle opisane role i brak jasnego warunku zakończenia. Rozjazd między agentami, czyli głuchy telefon, podwójna praca i decyzje podjęte bez wiedzy o decyzjach innych. Brak weryfikacji, czyli nikt nie sprawdził wyniku. Bez centralnej kontroli błędy wzmacniają się kilkanaście razy, z nią kilka razy, dlatego oceniający i sędzia są warunkiem, a nie dodatkiem.
Czym orkiestracja agentów różni się od automatyzacji w Make, Zapierze czy n8n?
Zwykła automatyzacja to przepływ narysowany przez człowieka, w którym model wypełnia luki, a o kolejności decyduje diagram. Orkiestracja zaczyna się tam, gdzie agent prowadzący sam dzieli zadanie i decyduje, kogo powołać. Make, n8n i Zapier pozwalają dziś zbudować oba rodzaje, bo w każdym z nich agent może wywoływać innych agentów jako narzędzia. Różnica leży w tym, kto decyduje o podziale pracy, kod czy model.
Czy klasyczny system wieloagentowy z informatyki to to samo co rój agentów AI?
Nie. Klasyczne systemy wieloagentowe badane od lat osiemdziesiątych dotyczą programów o ustalonych regułach, robotów i symulacji, i to je opisuje polska Wikipedia. Rój agentów AI, o którym piszemy, to zespół agentów opartych na modelach językowych, który istnieje od około 2023 roku. Łączy je słowo i kilka pomysłów, na przykład komunikacja przez wiadomości i podział ról, ale narzędzia, koszty i tryby awarii są zupełnie inne. Gdy w ofercie czytasz o rojach agentów, rojach botów albo systemie multiagentowym, chodzi o to drugie.
Kim są subagenci?
To pomocnicy powoływani przez agenta prowadzącego do jednego zadania. Każdy pracuje we własnym oknie kontekstu, z własną instrukcją, własnymi narzędziami i uprawnieniami, a po wykonaniu pracy oddaje prowadzącemu tylko streszczenie, zwykle tysiąc do dwóch tysięcy tokenów, i znika. Dzięki temu prowadzący nie zapycha pamięci szczegółami. Claude Code, Codex, Devin, OpenClaw i Hermes mają subagentów wbudowanych.
Czym jest MCP, a czym A2A, i czy mała firma ich potrzebuje?
MCP łączy agenta z narzędziami i danymi firmy, A2A łączy agentów ze sobą, także między firmami. MCP jest dziś standardem i warto go mieć, bo tak agent podłącza się do systemów. A2A przyda się dopiero wtedy, gdy Twój agent ma rozmawiać z agentem innej firmy albo gdy składasz rój z narzędzi różnych producentów. Wewnątrz jednego frameworku agenci rozmawiają ze sobą bez A2A.
Od czego zacząć w małej firmie?
Od jednego agenta i jednego procesu, który powtarza się codziennie i kończy w systemach firmy. Gdy agent zacznie gubić się w materiale, myli narzędzia albo potrzebuje uprawnień, których nie chcesz mu dać w całości, dołóż drugiego i od razu dołóż kogoś, kto sprawdza wynik. Zanim zbudujesz rój, policz, czy wartość zadania pokryje rachunek kilkanaście razy wyższy niż za rozmowę. Jeśli chcesz to przeliczyć dla konkretnego procesu, porozmawiajmy.
[MINI-BANER CTA, paleta olyve]
Nie wiesz, czy Twój proces potrzebuje jednego agenta, prowadzącego z pomocnikami czy pełnego roju z nadzorcą? Ustalimy to razem na bezpłatnej konsultacji.
Przycisk: "Umów konsultację" -> kalendarz rezerwacji/ link doPobieram wolne terminy z kalendarza.../agenty-si/