Data: 2026-10-27. Źródła: cztery raporty researchu w tym folderze (wzorce, efekty, narzędzia, konkurencja) i frazy seo/frazy/2026-10-orkiestracja.csv. Artykuł-matka: artykuly/2026-10-agent-asystent-chatbot/ (prod 6129). Status: brief do akceptacji, tekst niepisany.
1. Teza i kąt
Orkiestracja to nie "więcej agentów", tylko świadomy podział kontekstu, uprawnień i odpowiedzialności. Drugi agent ma sens dopiero wtedy, gdy pierwszy nie mieści się w kontekście, w uprawnieniach albo w czasie. W pozostałych przypadkach płacisz kilkanaście razy więcej tokenów za ładny schemat organizacyjny.
Kąt wynika z luki: polskie teksty to tłumaczenia dostawców (ElevenLabs, Unite.AI, ClickUp, Microsoft Learn), hasła słownikowe i zalążek w Wikipedii bez słowa o LLM. Nikt w PL nie pyta "czy w ogóle potrzebujesz wielu agentów", nie podaje trybów awarii ani nie rozplątuje znaczeń słowa "orkiestracja". Angielska czołówka (Anthropic, Microsoft Azure Patterns, Cognition) robi to dobrze i to jest poziom, do którego celujemy, po polsku i dla właściciela firmy.
Ciągłość z artykułem-matką: tam drabinka kończy się na roju. Tu zaczynamy od tego szczebla i rozbieramy go na części.
2. Frazy (Planer PL, 2026-10-27)
| fraza | mies. |
|---|---|
| agentic ai | 1300 |
| model context protocol | 720 |
| orkiestracja | 480 |
| multi agent system | 260 |
| a2a protocol | 210 |
| claude code subagents | 170 |
| openai agents sdk | 170 |
| ai orchestration | 90 |
| subagent | 90 |
| agent orchestration | 70 |
| agent swarm | 70 |
| system wieloagentowy / systemy wieloagentowe | 40 + 40 |
| orkiestracja agentów ai | 10 |
Focus: "system wieloagentowy" z angielskim "multi agent system" w nawiasie i chmurce (260 bez dobrego polskiego wyniku). Pomocniczo: orkiestracja agentów AI, subagenci, MCP i A2A (sekcja protokołów łapie 720 + 210). Intencja "system wieloagentowy" jest mieszana (studenci szukają klasycznych MAS), dlatego akapit rozplątujący znaczenia jest obowiązkowy. Definicja w pierwszym akapicie pod featured snippet.
Tytuł (wybrany przez usera 2026-10-27): "Orkiestracja agentów AI: kiedy jeden agent nie wystarczy". Fraza "system wieloagentowy (multi agent system)" w pierwszym akapicie i w H2.
3. Struktura (H2 i H3, każdy wzorzec z figurą lub bajerem, jak w artykule-matce)
- Co to jest orkiestracja agentów AI. Definicja w dwóch zdaniach. H3 "Pięć rzeczy, które nazywa się orkiestracją": klasyczne systemy wieloagentowe z informatyki, Kubernetes i kontenery, RPA i automatyzacje, routing modeli, roje agentów LLM. Figura: pięć "orkiestr", tylko jedna jest tematem.
- Najpierw jeden agent. Wszyscy producenci mówią to samo: OpenAI "maximize a single agent's capabilities first", Microsoft "if you can write a function... do that instead", Anthropic "simplest solution possible". H3 "Trzy powody, żeby dzielić": kontekst (za dużo do przeczytania), uprawnienia (różne klucze dla różnych ról), czas (praca równoległa). Progi producentów jako ciekawostka: Microsoft dzieli przy 30-40 akcjach, Zapier radzi mniej niż 5 wywołań podagentów, Claude Code zaczyna zespoły od 3-5 członków. Figura: trzy wskaźniki przepełnienia.
- Kto decyduje o podziale pracy: kod czy model. Oś z "Building effective agents": workflow (podział zapisany w kodzie) kontra agent (model sam powołuje pomocników). H3 dla każdego wzorca z biznesowym przykładem:
- potok (prompt chaining, sequential): oferta przechodzi przez kolejne stanowiska,
- rozwidlenie i głosowanie (parallelization, sectioning/voting): trzy modele oceniają ryzyko umowy,
- prowadzący i roboczy (orchestrator-workers, supervisor, manager): sto umów rozdzielonych na podagentów,
- przekazanie rozmowy (handoff): infolinia, która oddaje klienta reklamacjom,
- agent jako narzędzie (agents as tools): wraca tylko streszczenie, prowadzący trzyma ster,
- narada (group chat, magentic): kilku ekspertów przy jednej tablicy z planem,
- sieć i rój (swarm, network): każdy może oddać pałeczkę każdemu, najtrudniejsza do kontroli.
Animacje: pętle kręcą się, pojedyncze wywołania mają znacznik HTTP, jak w artykule-matce.
- Agenci nadzorczy. Oceniający (evaluator-optimizer), strażnik (guardrail z tripwire, np. blokada PESEL), sędzia (LLM-as-judge), człowiek w pętli (checkpoint, np. zwrot 5 000 zł czeka na kierownika). Najmocniejszy argument: agenci "reliably skew positive when grading their own work" (Anthropic, marzec 2026), więc oceniać powinien ktoś inny niż autor.
- Orkiestracja modeli, czyli drogi myśli, tani robi. Drugie znaczenie terminu. Kaskady (FrugalGPT), routing (RouteLLM: ponad 85% taniej przy 95% jakości), mixture-of-agents, odwrócony wzorzec doradcy (Haiku z doradcą Opus: 41,2% kontra 19,7% na BrowseComp, przy koszcie niższym o 85% niż sam Sonnet). Studzenie: LLMRouterBench (styczeń 2026) pokazuje, że wiele routerów nie bije prostego punktu odniesienia.
- Co mówią dane: kiedy rój wygrywa, a kiedy przegrywa. Patrz tabela liczb niżej. Puenta Cognition z kwietnia 2026: "map-reduce-and-manage", myśli wielu, pisze jeden. Stanford (Tran i Kiela, kwiecień 2026): przy tym samym budżecie tokenów pojedynczy agent dorównuje rojowi. Figura: wykres od +80,9% do -70% (Google Research).
- Jak się psuje. Taksonomia MAST (14 trybów awarii), głuchy telefon w supervisorze, mnożenie błędów 17,2x bez koordynacji i 4,4x z nią, pętle bez końca, podwójne akcje. Bezpieczeństwo: prompt injection przechodzący między agentami (OWASP ASI07 i ASI08, przypadek ServiceNow), uprawnienia podagentów, budżety i limity kroków (Claude Agent SDK: 3 poziomy zagnieżdżenia, 20 podagentów naraz, budżet w USD).
- Narzędzia: od n8n po Claude Code. No-code: n8n (AI Agent Tool, n8n Agents w preview od 5.08.2026), Make (Sub-Agents od lipca 2026), Zapier (Sub-Zap). Platformy: Copilot Studio (GA multi-agent kwiecień 2026, A2A), Agentforce, AWS Bedrock i AgentCore, Gemini Enterprise. Frameworki: OpenAI Agents SDK, Claude Agent SDK, Google ADK, Microsoft Agent Framework 1.0 (5 wzorców), LangGraph, CrewAI. Gotowe agenty z rojem w środku: Claude Code, Codex, Devin ("Devin can now Manage Devins"), Cursor, Manus Wide Research (100+ agentów). H3 "MCP i A2A po ludzku": MCP łączy agenta z narzędziami (pion), A2A łączy agentów ze sobą (poziom). Figura: mapa narzędzi w stylu artykułu-matki.
- Z naszej stajni: loop-manager. Nasz orkiestrator, w którym widać prawie każdy wzorzec z artykułu naraz (sekcja 6). Krótsze przykłady: research do tego artykułu i generator reklam.
- FAQ (10 pytań, sekcja 5) i CTA do kontaktu oraz
/agenty-si/.
Szacunek: 4000-4500 słów, 9-11 figur, chmurki na terminach angielskich (handoff, orchestrator-workers, guardrail, LLM-as-judge, MCP, A2A, okno kontekstu, subagent, routing, kaskada, map-reduce).
4. Liczby do artykułu
| liczba | co znaczy | źródło | status |
|---|---|---|---|
| +90,2% | Opus 4 z podagentami Sonnet 4 kontra sam Opus 4, research | Anthropic, 13.06.2025 | otwarte |
| ok. 15x i 4x | tokeny roju i pojedynczego agenta względem czatu | Anthropic, 13.06.2025 | otwarte |
| 80% | tyle wariancji wyniku wyjaśnia samo zużycie tokenów | Anthropic, 13.06.2025 | otwarte |
| od +80,9% do -70% | rój pomaga na zadaniu rozkładalnym, szkodzi na sekwencyjnym, 260 konfiguracji | Google Research / Kim i in., arXiv 2512.08296 | otwarte |
| ok. 45% | powyżej tej skuteczności pojedynczego agenta dokładanie agentów daje ujemny zwrot | jw. | otwarte |
| 17,2x / 4,4x | wzmocnienie błędów bez koordynacji i z koordynacją centralną | jw. | otwarte |
| 41-86,7% | odsetek porażek 7 otwartych frameworków, 14 trybów awarii (MAST) | Cemri i in., arXiv 2503.13657 | otwarte |
| 41,2% kontra 19,7% | Haiku z doradcą Opus kontra sam Haiku | Anthropic, 9.04.2026 | otwarte |
| ponad 85% taniej | routing tani/drogi przy 95% jakości GPT-4 (dane z 2024) | RouteLLM, LMSYS | otwarte, stare |
| 1,35 kontra 3,51 USD | koszt zadania Devin Fusion (drogi plus tani model) | Cognition, dane dostawcy | otwarte |
| ponad 40% | projektów agentowych anulowanych do końca 2027 (prognoza) | Gartner, 25.06.2025 | 403, do ręcznego sprawdzenia |
Odrzucamy: "1445% więcej zapytań o MAS" i "96% na SWE-bench" (brak źródła pierwotnego), anegdotę o pętli za 47 tys. USD, statystyki McKinsey, Capgemini i MIT NANDA bez potwierdzenia u źródła. Cen w złotówkach nie podajemy (decyzja z artykułu-matki). Koszt pokazujemy jako krotność tokenów.
5. FAQ (propozycja)
- Czym jest orkiestracja agentów AI prostymi słowami?
- Czym system wieloagentowy różni się od jednego agenta z wieloma narzędziami?
- Kiedy jeden agent wystarczy, a kiedy potrzeba kilku?
- Ile więcej kosztuje system wieloagentowy?
- Dlaczego systemy wieloagentowe zawodzą?
- Czym orkiestracja agentów różni się od automatyzacji w Make, Zapierze czy n8n?
- Czy "system wieloagentowy" z informatyki to to samo co zespół agentów LLM?
- Kim są subagenci?
- Czym jest MCP, a czym A2A, i czy mała firma ich potrzebuje?
- Od czego zacząć w małej firmie?
6. Dowód z praktyki MTZN
6.1 Loop-manager (@mtzn/loop), nasz orkiestrator (przykład główny)
Źródło: prywatne repo DawidGrabanowski/loop-manager (README, KONCEPCJA.md), badanie loop-rlm i przebieg refaktoru z 22-23.10.2026 (notatka nadzoru w pamięci). Pakiet @mtzn/loop, CLI i TUI w Node.js.
Jak działa, w kolejności, w jakiej warto to opowiedzieć:
- Plan jako umowa. Człowiek pisze
plan.mdz listą checkboxów. Każdy punkt ma model (np. haiku, sonnet, opus, fable albocodex:dla Codexa), trybS(po kolei) alboA(sąsiednie punkty idą równolegle), limity tur, czasu i budżetu. Przed startem plan przechodzi audyt parserem i agentem, aloop fixnaprawia jego format. - Świeży agent na każdy punkt. Loop bierze pierwszy niewykonany punkt i uruchamia dla niego nowego agenta Claude Code (
claude -p). Każdy pracuje we własnym, czystym kontekście. To wprost odpowiedź na problem okna kontekstu z sekcji 2. - Koniec zadania to odhaczony checkbox, a nie koniec procesu. O stanie decyduje plik planu, nie to, co agent mówi. Agent, który skończył bez odhaczenia, dostaje jedną próbę "sprawdź stan i dokończ". Po awarii loop wznawia sesję z backoffem, a przy limicie abonamentu czeka do resetu.
- Commit i tag po każdym punkcie. Gitem zarządza wyłącznie loop. Agentom bramka blokuje zmiany historii, więc stan repo zawsze zgadza się z planem.
- Strażnik (guardrail) jako twarda bramka. Incydent z 14.09.2026: agent wydał polecenie zabicia wszystkich procesów node i zabił sam orkiestrator. Od tego dnia każde polecenie powłoki agenta przechodzi hook
PreToolUse, który odmawia zabijania cudzych procesów, działa w trybie fail-closed i loguje każdą decyzję. Świetna historia do sekcji o agentach nadzorczych: "sama instrukcja w prompcie to za mało". - Punkt kontrolny
K, czyli oceniający. Commit mówi tylko, że agent skończył, nie że etap jest dobry. Agent kontroli czyta zmiany i dzienniki, uruchamia aplikację, mierzy i wydaje werdykt: akceptuj, cofnij od wskazanego punktu albo zatrzymaj i oddaj decyzję człowiekowi. Przy cofnięciu musi dopisać do planu wnioski, co nie zadziałało i jak robić teraz. "Plan staje się pamięcią przebiegu", a odrzucony stan zostaje pod tagiemloop/cykl-k-n. - Wiele silników i środowisk. Ten sam plan może puścić punkt na Claude Code albo na Codexie, lokalnie, w Dockerze, w piaskownicy E2B albo na zdalnej maszynie. To orkiestracja modeli w praktyce: tani model do prostych punktów, mocny do trudnych.
- Drzewo loopów. Agent może uruchomić podloop na innej maszynie. Każde zlecenie to nowy przebieg, logi i sterowanie płyną w górę, a ścieżka węzłów i limit przeskoków odcinają cykle. To hierarchia z sekcji 3, zbudowana na prawdziwych maszynach.
- Dozorca nad orkiestratorem. Osobna sesja Claude Code z własną pętlą nadzoruje przebieg loopa (opis w 6.1b).
- Planista RLM w badaniu. Repo
loop-rlmsprawdza, czy planista w stylu Recursive Language Models może przejąć punkt kontrolny: werdykt, usterki, właścicieli i diff planu. Eksperyment sam jest planem loopa, czyli loop bada, jak lepiej zarządzać loopem.
Liczby, które można pokazać:
| co | wartość | źródło |
|---|---|---|
| przykład kalkulatora naukowego | 6 z 6 punktów w 33 min 51 s, modele haiku, sonnet, opus i fable, równoległe punkty A, 141 testów | KONCEPCJA.md, 2026-09-14 |
| przebieg refaktoru etapu 4 | 29 punktów, tempo ok. 25-35 min na punkt | notatka nadzoru, 23.10.2026 |
| szacunkowy koszt punktu | ok. 5,5 USD na punkt (szacunek klienta, praca szła z abonamentu) | jw. |
jedna kontrola K |
werdykt "cofnij" z trzema punktami naprawczymi, 137 tur, ok. 2 h 30 min, szacunek 13,68 USD | README loop-rlm, cykl 3 z 24.10.2026 |
Puenta do sekcji: najtrudniejsza część orkiestracji nie leży w uruchamianiu agentów. Trudne jest ustalenie, kto decyduje, że praca jest skończona i dobra. W loopie decyduje plik planu, bramka i osobny kontroler, nigdy wykonawca.
Decyzje usera (2026-10-27): pakiet nazywamy @mtzn/loop; kwoty w USD podajemy (z dopiskiem, że to szacunek liczony z tokenów); zrzut TUI pokazujemy (loop.png w tym folderze).
6.1b Przykład zaawansowany: agent nadzoruje orkiestrator, który prowadzi wielu agentów
To jest centralny przykład sekcji i najmocniejszy dowód z praktyki w całym artykule. Działa teraz na drugim komputerze przy refaktorze samego loopa (etap 5, 32 punkty).
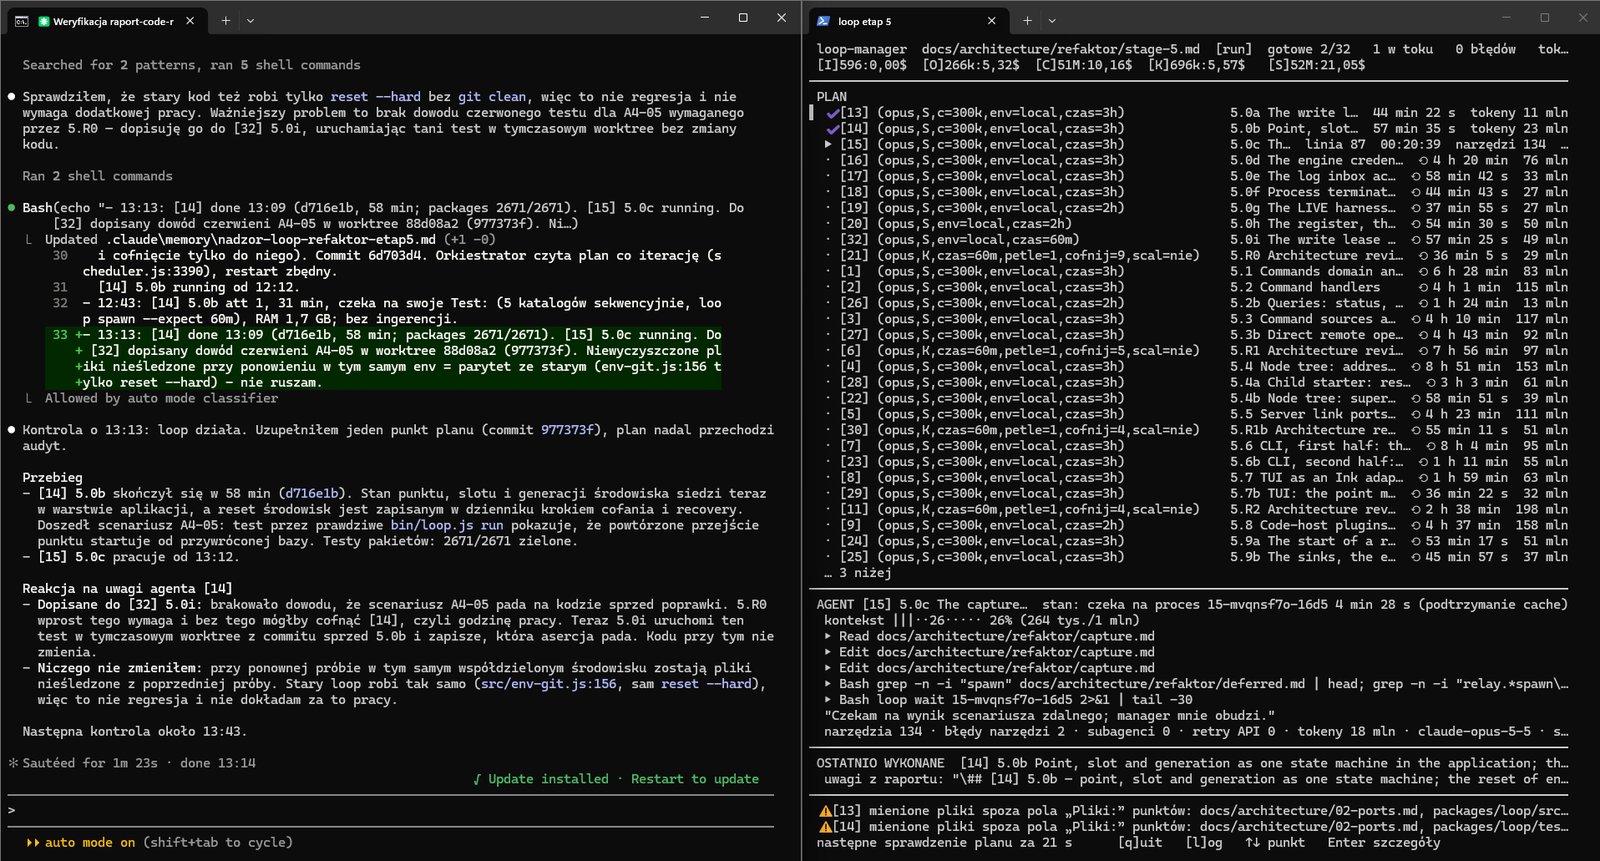
Trzy piętra pętli, od dołu:
- Wykonawcy. Każdy punkt planu robi osobny agent Opus we własnym kontekście (do 300 tys. tokenów, limit czasu 2-3 h na punkt). Agent czyta, edytuje, uruchamia testy, odhacza swój punkt i kończy pracę. Na zrzucie widać, ile trwał każdy punkt (od kilkudziesięciu minut do kilku godzin) i ile zużył tokenów (od kilkunastu do prawie 200 mln, z czego większość to odczyt z pamięci podręcznej).
- Orkiestrator z punktami kontrolnymi. Loop-manager rozdziela punkty, pilnuje kolejności, commituje po każdym punkcie i liczy koszt. Co kilka punktów stoi kontrola
K(na zrzucie: przeglądy architektury 5.R0, 5.R1, 5.R1b, 5.R2). Kontrola ma własne limity, na przykład "cofnij=9", czyli może do dziewięciu razy cofnąć etap do wskazanego punktu i kazać go zrobić od nowa z dopisanymi wnioskami. To drugi poziom pętli: wykonawcy krążą w swoich pętlach, a kontrola zawraca całe fragmenty planu. - Agent nadzorujący przebieg. W terminalu obok działa sesja Claude Code z własną, natywną pętlą (
/loop), która co około 30 minut robi kontrolę przebiegu. Czyta stan, dzienniki i raport, porównuje postęp z planem i reaguje według zapisanych wytycznych. Restartuje loop po awarii, poprawia i usprawnia plan, zgłasza problemy i wnioski optymalizacyjne. Nie zmienia kodu, a jego zadaniem jest doprowadzić procedurę refaktoru do końca zgodnie z planem.
Konkretna scena ze zrzutu (kontrola o 13:13). Dozorca zauważył, że punkt [14] skończył się w 58 minut, wszystkie 2671 testów pakietu przeszło, ale brakuje dowodu, którego wymaga najbliższa kontrola 5.R0: testu pokazującego, że scenariusz A4-05 pada na kodzie sprzed poprawki. Bez tego kontrola mogłaby cofnąć [14], czyli wyrzucić godzinę pracy. Dozorca nie ruszył kodu. Dopisał wymaganie do punktu [32] 5.0i, tak żeby kolejny wykonawca uruchomił tani test w tymczasowym worktree i zapisał, która asercja pada. Zapisał też, czego nie zmienił i dlaczego: pozostałości po poprzedniej próbie w tym samym środowisku to zachowanie zgodne ze starym kodem, nie regresja. Plan nadal przechodził audyt, a następna kontrola była zaplanowana na 13:43.
Co pokazuje ten przykład, w języku artykułu:
- hierarchia (orkiestrator nad wykonawcami, agent nad orkiestratorem, człowiek nad wszystkimi),
- oceniający, który może cofać pracę (kontrola K),
- strażnik (bramka procesów),
- człowiek w pętli zastąpiony agentem, który działa według wytycznych i raportuje człowiekowi,
- plan jako wspólna pamięć: dozorca i kontrola poprawiają plan, a kolejni wykonawcy czytają poprawki,
- najważniejsza lekcja: dozorca zapobiega kosztownemu cofnięciu, zanim do niego dojdzie, bo widzi, czego będzie wymagać następny punkt kontrolny.
Kwoty do artykułu (szacunek z liczby tokenów według cennika API, praca idzie z abonamentu):
| przebieg | wartość |
|---|---|
| etap 4, po 19 z 29 punktów | ok. 158 USD |
| etap 4, średnio na punkt | ok. 5,5 USD, 25-35 min |
| jedna kontrola K (cykl 3 etapu 4) | 13,68 USD, 137 tur, ok. 2 h 30 min, werdykt "cofnij" z trzema punktami naprawczymi |
| etap 5, licznik w nagłówku TUI | sumy tokenów i kosztu według rodzaju (wejście, wyjście, pamięć podręczna, model) |
Do uzupełnienia przed pisaniem: końcowy koszt i czas etapu 5 (przebieg trwa), liczba cofnięć wykonanych przez kontrole, liczba interwencji dozorcy w całym etapie. Zrzut przed publikacją przyciąć albo opisać tak, żeby było jasne, które okno jest czym.
6.2 Krótsze przykłady
- Ten artykuł. Model decyzyjny zlecił zebranie danych czterem agentom Opus pracującym równolegle (wzorce, efekty, narzędzia, konkurencja), każdy we własnym kontekście, a do redakcji trafiły tylko ich raporty. To czysty orchestrator-workers: łącznie ok. 690 tys. tokenów agentów i ok. 12 minut.
- Generator reklam. Agent tworzy kreację, osobny etap kontroli jakości z wizją ocenia obraz, pętla do trzech prób na wariant, a ludzkie oceny z panelu uczą generator. Wzorzec oceniający plus człowiek w pętli.
7. Propozycje figur i bajerów
- "Pięć orkiestr" (pięć znaczeń słowa, cztery wygaszone, jedna świeci).
- Wskaźniki przepełnienia: kontekst, uprawnienia, czas.
- Przełącznik wzorców (jak drabinka w artykule-matce): potok, rozwidlenie, prowadzący, handoff, agent jako narzędzie, narada, rój. Jedna figura z etapami zamiast siedmiu osobnych, plus mniejsze ilustracje przy H3.
- Agent jako narzędzie kontra handoff: kto trzyma ster rozmowy.
- Agenci nadzorczy: oceniający, strażnik, sędzia, człowiek z przyciskiem stop.
- "Drogi myśli, tani robi": kaskada i doradca.
- Wykres Google Research: zysk i strata roju według typu zadania.
- Głuchy telefon i mnożenie błędów (17,2x kontra 4,4x).
- Mapa narzędzi i protokołów (MCP pion, A2A poziom).
- Schemat loop-managera: plan z checkboxami, świeży agent na punkt, bramka, kontrola K z trzema werdyktami, drzewo podloopów na maszynach. Pętle kręcą się, odhaczanie punktów animowane.
- Zrzut TUI loopa z nadzorującą sesją Claude Code (
loop.png) z podpisami: "wykonawcy", "kontrola K", "dozorca".
Bez gry (decyzja usera 2026-10-27).
8. Linki
Do: artykuł-matka 6129 (drabinka), /agenty-si/, /automatyzacje-procesow/, artykuł o halucynacjach, filar budowy agentów po publikacji. Z artykułu-matki: dwa miejsca "opisujemy w osobnym artykule" plus FAQ (backlog B1).
9. Poprawki uboczne
Flowise jest potwierdzony jako wygaszony (code freeze 29.07.2026, archiwum 10.08, koniec 31.08.2026). Artykuł-matka już oznacza go jako EOL, więc wystarczy sprawdzić, czy nigdzie go nie poleca.
10. Do ręcznej weryfikacji przed publikacją
Gartner 40% (403), data poradnika OpenAI, definicje agentów ADK (przekierowanie), data GA Microsoft Agent Framework (źródła podają kwiecień i lipiec 2026), przeniesienie A2A do Agentic AI Foundation (jedno źródło wtórne), licencje frameworków w tabeli, OWASP z omówienia Giskarda zamiast PDF. Cytaty z WebFetch pochodzą z tekstu przepisanego przez model, więc kluczowe zdania trzeba kliknąć u źródła.